
昨天我們先把 Plan 的格式定義好。
每一步要做什麼、要讀哪個檔案,都有固定結構,也會經過 Pydantic 和路徑規則驗證。
但昨天的 Plan 是我們自己填的。
今天才正式把 Planner 交給模型:
使用者任務
↓
Planner 產生 Plan
↓
驗證 Plan
↓
Executor 執行
↓
根據實際資料整理答案
這次不再加 LangGraph。
先用普通 Python 把 Planner、Executor 和結果彙整三個角色拆開,看清楚資料到底怎麼流動。
Day 15 已經用 Pydantic 定義好:
class PlanStep(BaseModel):
    model_config = ConfigDict(extra="forbid")

    purpose: str = Field(
        min_length=1,
        max_length=300,
    )

    path: str = Field(
        min_length=1,
        max_length=200,
    )


class Plan(BaseModel):
    model_config = ConfigDict(extra="forbid")

    steps: list[PlanStep] = Field(
        min_length=1,
        max_length=4,
    )
今天直接把同一份 Schema 交給 Ollama:
response = await llm.chat(
    messages,
    response_schema=Plan.model_json_schema(),
    max_tokens=1600,
    think=False,
)

plan = (
    Plan
    .model_validate_json(response.message.content)
    .validate_scope()
)
這樣不用維護兩套規格:
給模型看的輸出格式
Pydantic 實際驗證的格式
兩邊都來自:
Plan.model_json_schema()
但這裡要分清楚一件事。
Structured Output 能限制的是:
JSON 長什麼樣子
它不能保證:
Plan 的內容一定合理
例如模型完全可以產生:
{
  "steps": [
    {
      "purpose": "取得環境設定",
      "path": ".env.local"
    }
  ]
}
JSON 很漂亮。
Schema 也完全合法。
但這個路徑不允許讀取。
所以後面還是要經過:
validate_scope()
去檢查:
路徑是否允許
有沒有重複檔案
有沒有路徑穿越
步驟是否符合目前 Executor 的能力
也就是:
Structured Output
解決格式問題

Policy Validation
解決能不能執行
兩件事不能混在一起。
完整流程變成:
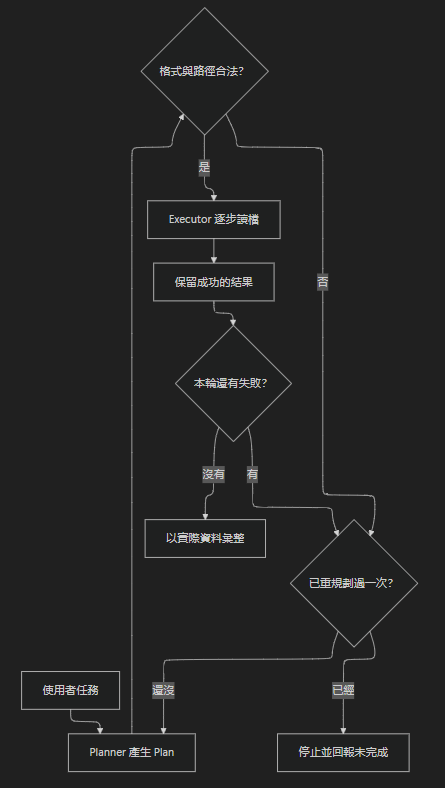
這裡刻意把責任拆開:
Planner
→ 決定要做哪些事

Validator
→ 決定 Plan 能不能執行

Executor
→ 真正呼叫 MCP Tool

Synthesizer
→ 根據 Observation 整理答案
模型提出:
我要讀 config.py
不代表它真的讀過。
真正的資料仍然只能從 Executor 執行後取得的 Observation 來。
這跟前面 ReAct 的原則一樣:
模型提出的是行動,工具回傳的才是實際結果。
Plan-and-Execute 很快就會遇到一個問題。
假設第一輪 Plan 是:
Step 1 → config.py
Step 2 → llm.py
其中:
config.py → 成功
llm.py    → 失敗
如果重新規劃後又得到:
Step 1 → config.py
Step 2 → client.py
config.py 還需要再讀一次嗎?
這次我們把成功結果放進:
completed
並以檔案路徑作為索引。
概念上像:
completed = {
    "src/ironman/config.py": observation,
}
新的 Plan 如果再次出現相同路徑,就直接使用已完成的 Observation,不重新執行。
所以流程不是:
Re-plan
↓
全部重跑
而是:
Re-plan
↓
保留已完成工作
↓
只執行還沒完成的步驟
今天只是短時間讀檔,這樣已經夠用。
如果正式系統裡的檔案可能在執行期間被修改,就不能只記 path,還應該保存:
檔案版本
修改時間
內容雜湊
否則「剛才讀過」不一定代表「現在還是同一份內容」。
如果 Planner 一直產生錯誤 Plan:
規劃
↓
失敗
↓
重新規劃
↓
失敗
↓
重新規劃
↓
...
GPU 可以一直跑下去。
所以今天直接限制:
最多兩輪 Plan
也就是:
第一輪:原始 Plan

第二輪:一次修正 Plan
還是失敗就停止。
不會無限 Retry。
這裡跟 Day 13 的:
max_steps
tool_budget
其實是同一個觀念。
會自己重試的系統,就一定要有停止條件。
失敗也要成為明確結果,而不是一直跑到使用者手動把程式關掉。
第一次跑 Planner 時,模型回傳:
content = ""
也就是空字串。
接著:
Plan.model_validate_json(...)
當然直接失敗。
這次沒有自己補一份 JSON 假裝成功。
原始失敗結果有保留下來:
outputs/day16_initial_failure.txt
最後針對這個結構化輸出步驟設定:
think=False
同時保留足夠的輸出 Token,才成功取得可以解析的 Plan。
這裡不能直接下結論說:
Structured Output 一律要關 Thinking
不同模型、版本與能力可能不同。
這只是這次本機模型實測遇到的行為。
真正要記的是:
如果 Planner 的輸出本身就是程式下一步要解析的資料,就必須驗證實際 response,而不是假設模型一定會按照預期輸出。
後來又遇到另一種情況:
模型把同一個檔案拆成多個 Step。
例如:
{
  "steps": [
    {
      "purpose": "查看模型設定",
      "path": "src/ironman/config.py"
    },
    {
      "purpose": "確認端點設定",
      "path": "src/ironman/config.py"
    }
  ]
}
這次 JSON 完全正確。
Pydantic 也能解析。
問題是:
我們不希望同一個檔案在同一份 Plan 裡重複執行。
所以除了在 Prompt 裡明確要求:
每個檔案只安排一次
程式端仍然要檢查重複 path。
如果不符合規則,就進入受限的 Re-plan。
還是同一句:
Prompt 告訴模型規則
程式負責真的執行規則
今天的入口很短:
import asyncio
import json

from ironman.llm import OllamaClient
from ironman.mcp_bridge import devbench
from ironman.planning import execute_plan


async def main() -> None:
    async with devbench() as tools, OllamaClient() as llm:
        result = await execute_plan(
            llm,
            tools,
        )

        print(
            json.dumps(
                result,
                ensure_ascii=False,
                indent=2,
            )
        )

        assert result["status"] == "completed"


if __name__ == "__main__":
    asyncio.run(main())
Bridge 仍然是實際讀取檔案的唯一入口。
也就是:
Planner
不能直接碰檔案

Executor
也不能繞過 MCP Bridge
所以即使模型 Plan 裡寫了:
.env.local
真正執行時還是會被現有的權限規則擋下來。
🧪 隔離環境實測

這次結果裡會保留幾個重要欄位:
status
attempts
completed
answer
它們代表的事情不同。
attemptsPlanner 總共規劃了幾次。
例如:
attempts = 1
代表第一份 Plan 就成功完成。
如果是:
attempts = 2
代表中間發生過一次 Re-plan。
completed這是 Executor 真正成功取得 Observation 的項目。
它比 Planner 寫了什麼更重要。
Planner 可以說:
我要讀三個檔案
但 completed 才告訴我們:
實際成功讀到哪些資料
answer最後才是模型根據 Observation 整理出的答案。
所以檢查順序應該是:
Plan 是否合理
↓
Executor 是否真的成功
↓
Observation 是否完整
↓
最後答案是否符合證據
不能只因為最後一段文字讀起來很順,就認為整個任務成功。
即使:
status = completed
還是只代表整個 Plan-and-Execute 流程正常跑完。
不代表模型最後的每一句整理都一定正確。
例如原始碼裡可能有一段註解:
# TODO: 未來改成從環境變數載入
模型如果沒有分清楚:
目前實作
和:
未來預告
就可能把 TODO 寫成已經存在的功能。
所以:
Executor 成功
≠
答案自動正確
後面加入 Reviewer 和評估流程,就是為了處理這一層。
昨天我們只有:
人工 Plan
↓
Validator
今天則完整跑成:
Task
↓
Planner
↓
Structured Plan
↓
Validator
↓
Executor
↓
Observation
↓
必要時 Re-plan
↓
Answer
到這裡,Plan-and-Execute 已經真的由模型負責規劃。
而且整套流程沒有使用 Agent Framework。
這也是我想先手刻一次的原因。
接下來再看框架時,就比較容易分辨:
哪些事情是 Agent 本來就必須處理的

哪些事情只是 Framework 幫我們包起來
明天進入 Day 17:
Google ADK 是什麼?建立第一個 ADK Agent。
看看模型、Session、執行流程開始交給 Framework 管理之後,程式會變成什麼樣子。
Ollama Structured Outputs
https://docs.ollama.com/capabilities/structured-outputs
Ollama Thinking
https://docs.ollama.com/capabilities/thinking


 iThome鐵人賽
 看影片追技術